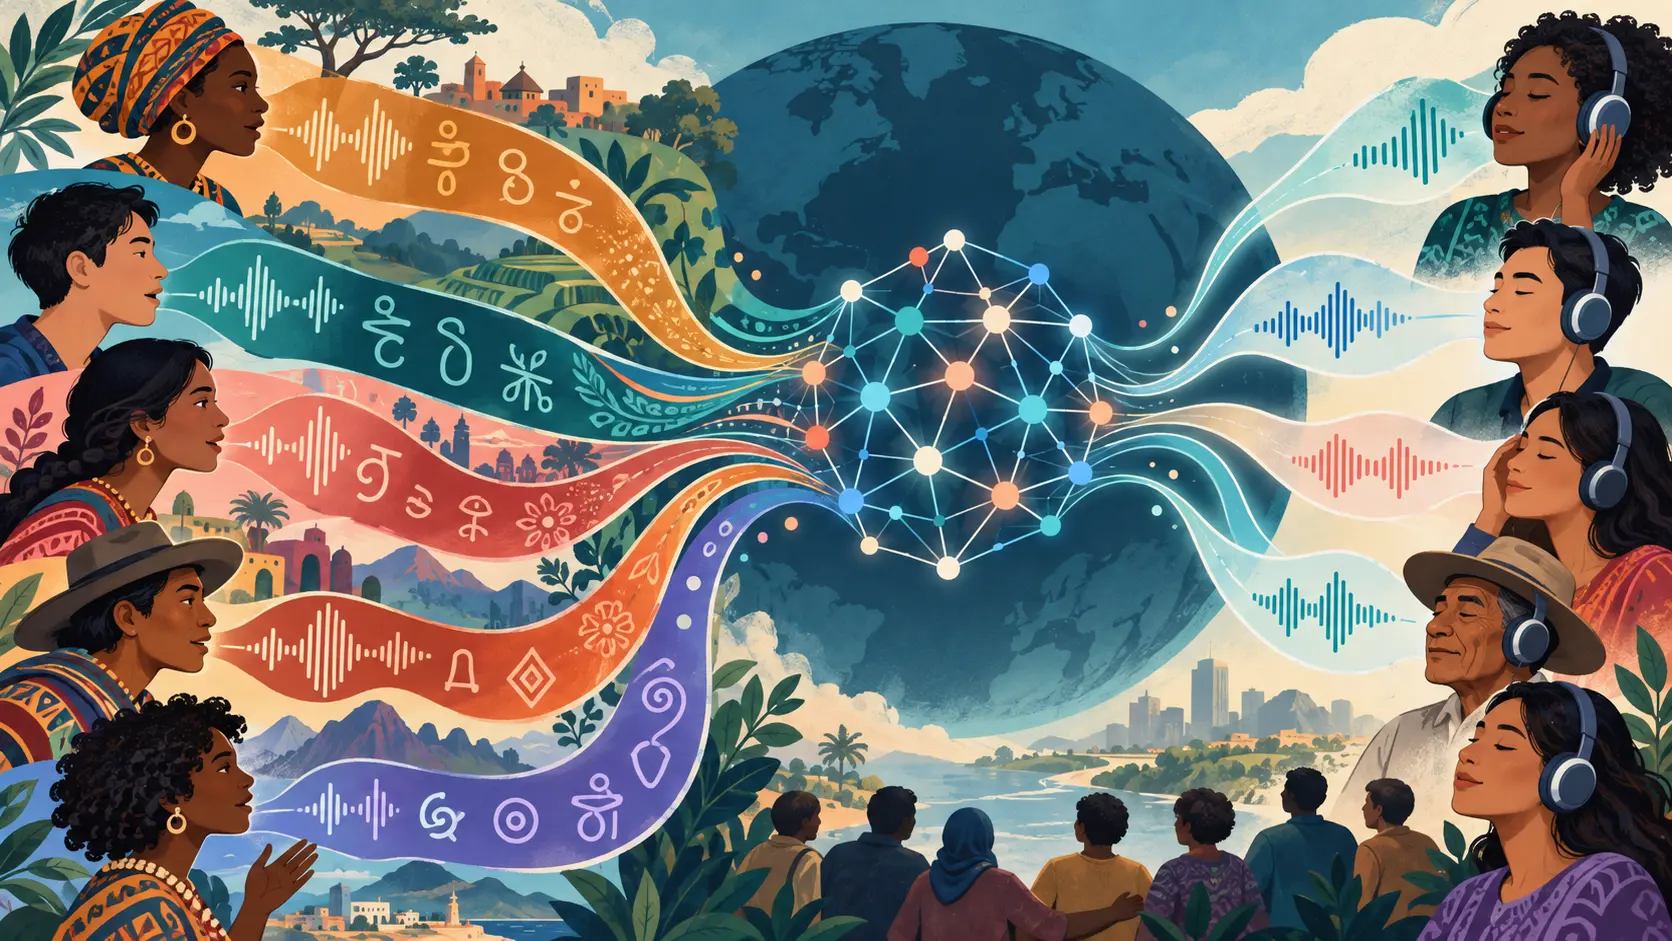
Une coalition de 60 organisations a annoncé le 21 septembre un objectif commun : permettre à quelque 3,4 milliards de personnes parlant des langues sous-représentées dans les modèles actuels d’utiliser des outils d’intelligence artificielle dans leur langue et avec la voix. L’initiative, présentée par la Gates Foundation, réunit des laboratoires d’IA, des entreprises, des universités, des gouvernements, des organisations communautaires et des institutions de développement.
Le problème est concret. Les modèles entraînés surtout sur les contenus disponibles en ligne reflètent mal de nombreuses langues, variantes régionales, expressions orales et contextes culturels. Une erreur de compréhension peut être anodine dans une conversation, mais beaucoup plus grave dans un service de santé, une aide agricole ou une démarche administrative. Associated Press cite l’exemple d’une expression utilisée au Malawi pour signaler la rupture de la poche des eaux, qu’un système pourrait traduire littéralement et perdre dans son sens médical.
La coalition annonce quatre axes : créer une infrastructure de données linguistiques ouvertes et sûres ; mesurer les progrès avec des tests comparables ; transformer ces données en modèles et applications accessibles à différents concepteurs ; et encadrer la collecte par la protection de la vie privée, le consentement et la souveraineté des données. Parmi les signataires figurent notamment Anthropic, Google, Microsoft, Mistral, Mozilla Data Collective, Nvidia, l’OpenAI Foundation, l’Unicef et la Banque mondiale.
L’ampleur de la liste ne vaut toutefois pas résultat. Le communiqué reconnaît que la structure de gouvernance, le secrétariat et les chantiers détaillés seront définis au cours de l’année suivante. Aucun calendrier langue par langue, budget consolidé ni indicateur public de couverture réelle n’est encore fourni. Le chiffre de 3,4 milliards désigne donc une population visée, pas un impact déjà observé.
Des travaux existants donnent néanmoins une base au projet. AP rapporte par exemple que Google finance la collecte de plus de 150 000 heures d’enregistrements dans les districts indiens afin de mieux couvrir les dialectes. La vraie mesure du progrès sera la capacité des communautés concernées à contrôler la collecte et l’usage de leurs voix, puis à constater une amélioration vérifiable de la compréhension dans des services utiles. La promesse est importante ; sa réalisation reste à démontrer.