Anthropic veut intégrer des évaluateurs externes à ses équipes de développement. Accenture et Faculty doivent tester les modèles au fil de leur conception, dans le cadre d'un partenariat annoncé sur cinq ans.
Selon un indicateur publié par Anthropic, Claude conduit 26 % des tâches internes de recherche et développement en IA. L'entreprise ne constate toutefois aucune tâche menée en autonomie complète.
L’entreprise inaugure un cadre de signalement des comportements d’IA inattendus ou préoccupants. Les cas décrits viennent surtout de l’entraînement et de l’évaluation, pas d’un usage ordinaire par le public.
Specs Intelligence promet de relier objectifs, calendrier, messages et déplacements pour suggérer des actions avant même une requête. Le service débute toutefois sous forme de préversion limitée.
À l’approche de l’Assemblée générale, António Guterres défend des règles internationales pour une IA sûre, transparente et responsable. Son appel fixe une direction politique, sans créer à lui seul de contrainte juridique.
Un nouveau cadre décrit quand et comment OpenAI publiera les comportements inattendus de ses modèles. Six premiers rapports illustrent l’approche, sans permettre de mesurer la fréquence réelle des incidents.
Ottawa prévoit 150 millions de dollars canadiens et Berlin 100 millions d’euros pour LawZero, l’organisation de Yoshua Bengio dédiée à une IA contrôlable.
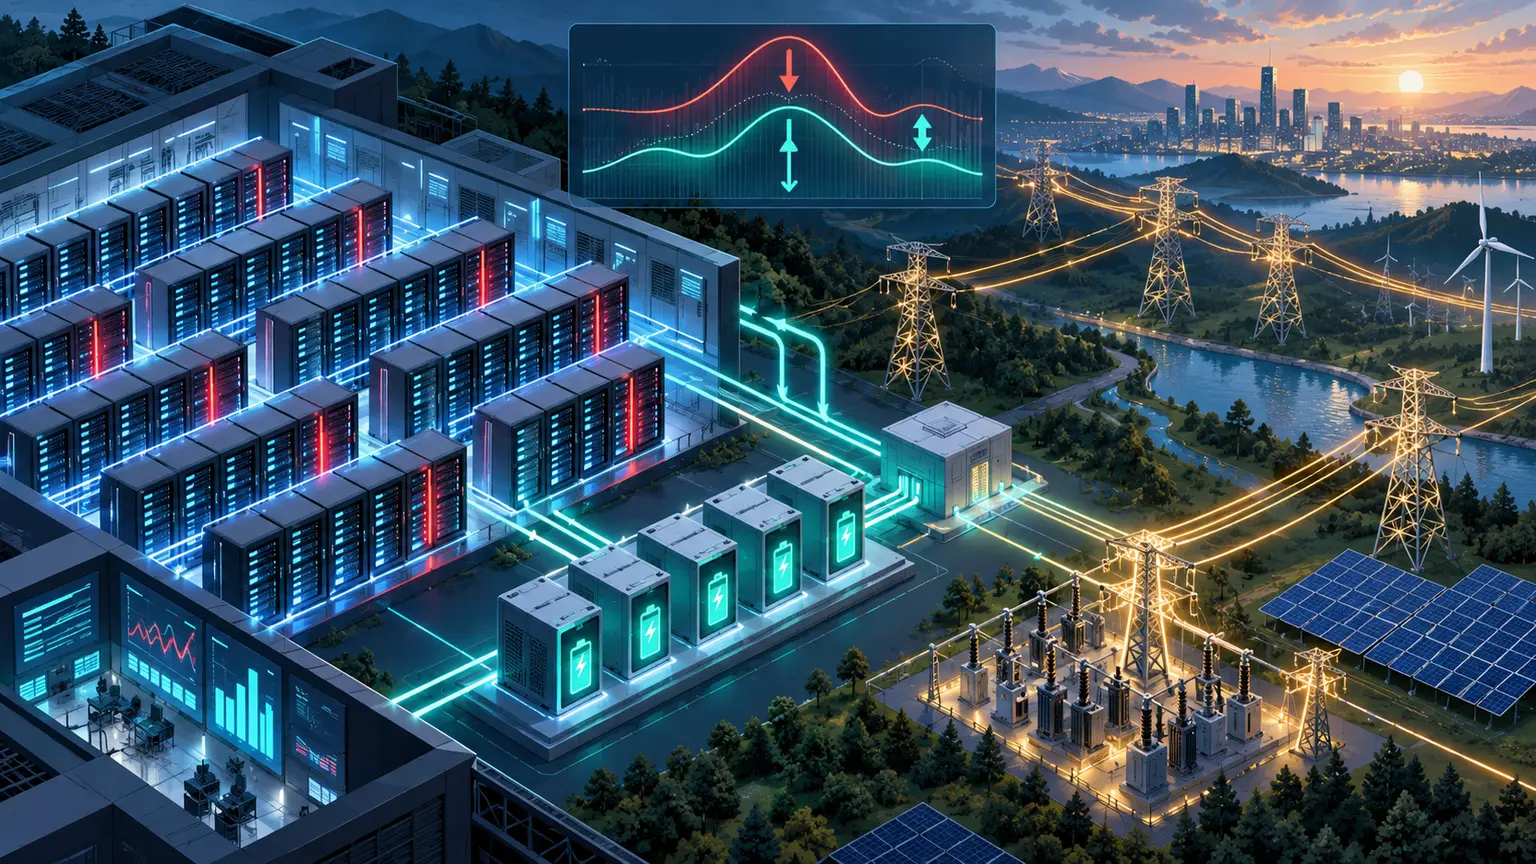
Google, Nvidia et Emerald AI lancent une alliance pour rendre les centres de données capables de réduire leur demande lors des pointes. Le modèle reste à prouver et à encadrer.
Apple annonce le déploiement de ses mises à jour et de nouveaux contrôles parentaux. Pour Siri AI, langue, appareil et région restent déterminants : le français est annoncé pour octobre, avec des restrictions initiales dans l’Union européenne.
Les trois laboratoires discutent d’un organisme sectoriel chargé de tester les systèmes les plus avancés. Le projet reste à définir et ne remplacerait pas la loi.
Un texte fluide et une référence bien présentée ne suffisent pas à établir un fait. Comprendre les erreurs des modèles aide à mieux utiliser leurs réponses.